 WeScale
Retour sur une conférence interne WeShare : comment une CLI de benchmark a été livrée en quinze jours par des agents Claude Code orchestrés en boucle — et pourquoi le concept qui a vraiment tenu la route n'était pas celui qu'on croyait.
Le titre de la session donne le ton : /loop et au lit. L'idée de départ est simple à énoncer et beaucoup plus difficile à tenir : poser une intention dans un fichier, lancer une boucle d'agents, aller dormir, et retrouver le lendemain matin une pull request prête à relire.
Sur quinze jours, cette mécanique a livré 73 features, orchestré 443 agents et consommé 7,76 milliards de tokens — pour un projet bien précis : une CLI interne de benchmark. Mais le vrai sujet de la conférence n'est pas la CLI elle-même. C'est ce qu'il a fallu comprendre, casser et reconstruire pour qu'une boucle d'agents puisse tourner sans supervision pendant des heures sans partir en vrille — et la découverte, assez tardive, que le mot « boucle » était le mauvais mot depuis le début.
Le projet : une CLI de benchmark, écrite en dormant
Le point de départ est concret. Il fallait un outil pour benchmarker des systèmes : on décrit ce qu'on veut mesurer dans un fichier de configuration, la CLI se charge de l'exécuter — rien à coder à côté. Le cahier des charges tient en trois lignes : un seul fichier de config et quelques verbes simples (appliquer, valider, récupérer, lancer un run) ; une exécution qui fonctionne aussi bien en local que sur de l'infrastructure distante ; un stockage centralisé qui range et retrouve ce que la CLI produit.
Rien, dans cet énoncé, ne dit comment l'outil a été construit. C'est précisément ce qui rend le récit intéressant : la totalité de la CLI — de la première brique de code jusqu'à la mise en production — a été écrite par des agents, avec un rôle humain réduit à la formulation des intentions et à la relecture finale.
La toute première brique, elle, n'est pas sortie d'une boucle. Avant qu'aucune boucle ne tourne, il fallait un point de départ — une base de code, pas encore un système. Cette brique initiale a été produite avec /ultracode, l'orchestrateur multi-agents de Claude conçu pour sortir un premier squelette exploitable en un seul shot. Un objectif unique — produire quelque chose sur lequel itérer — et rien de plus.
C'est seulement après ce premier shot que la vraie question de la conférence commence : comment faire tourner ça en continu, sans y être, sans que ça diverge ?
« Loop engineering » : encore un bullshit word ?
Premier arrêt : le vocabulaire. Après prompt engineering, context engineering et vibe coding, un nouveau terme circulait au moment de la conférence — le loop engineering, défini sur les réseaux comme la pratique consistant à relancer un agent IA en boucle jusqu'à ce qu'il produise quelque chose d'utilisable. La formule qui a fait le tour est signée Boris Cherny, le créateur de Claude Code, citée dans un tweet largement repris pendant l'été : « I don't prompt Claude anymore. I write loops and the loops do the work. My job is to write loops. »
Mon parcours, de l'intention au merge
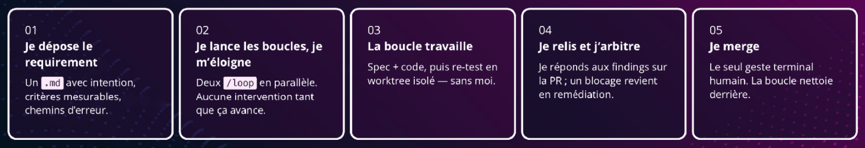
Sur le papier, le workflow humain se réduit à deux points de contact : formuler l'intention, puis relire. Entre les deux, la boucle travaille seule. En pratique, ce parcours se découpe en cinq étapes.
-
Je dépose le requirement — un fichier .md avec l'intention, des critères mesurables et les chemins d'erreur à couvrir.
-
Je lance les boucles, je m'éloigne — deux /loop tournent en parallèle, sans aucune intervention tant que ça avance.
-
La boucle travaille — spec puis code, avec un re-test en worktree isolé, sans intervention humaine.
-
Je relis et j'arbitre — je réponds aux findings sur la pull request ; un blocage revient en remédiation vers la boucle.
-
Je merge — le seul geste terminal humain du parcours. La boucle nettoie derrière elle.
Ce découpage en cinq étapes a une conséquence directe sur l'architecture technique : si le rôle humain se limite à déposer une intention et à trancher en review, tout ce qu'il y a entre les deux doit être conçu pour tourner en autonomie complète, y compris face à un CI qui échoue ou un test contract mal spécifié.
Deux boucles, deux cadences : build et ship
Le pipeline ne tourne pas comme une seule boucle monolithique. Il est scindé en deux boucles coopérantes, chacune à sa propre cadence :
/loop 15m /feature-loop build # lourd : inbox → impl + QA → commit
/loop 3m /feature-loop ship # léger : ouvre / watch PR, CI + review
build, toutes les ~15 minutes, draine l'inbox et les retours de remédiation, implémente et teste en worktree isolé, puis commit. Elle n'ouvre jamais de pull request. ship, toutes les ~3 minutes, ouvre la PR, surveille la CI et la review, auto-remédie ce qui peut l'être, et détecte le merge humain.
Cette séparation build / ship répond à un besoin de cadence différencié : implémenter et tester coûte du temps et des tokens, ça n'a pas besoin d'être vérifié à haute fréquence. Surveiller une CI ou une review, en revanche, doit réagir vite pour ne pas laisser une pull request stagner inutilement. Deux rythmes, deux responsabilités, un seul système.
Ça se réveille, ça bosse, ça se rendort
Rien ne tourne en continu pendant quinze jours. Toutes les quinze minutes, la boucle se réveille, lit dans un fichier où on en était, avance d'un cran, et se rendort. Trois propriétés rendent ce fonctionnement viable sans supervision :
-
Elle n'attend jamais. Une CI en cours ? Elle note où on en est et se rendort — elle repassera dans trois minutes plutôt que de bloquer le tour en cours.
-
Sa mémoire est un fichier, un par requirement. Le code, lui, vit dans un worktree jetable : la mémoire survit, le chantier non.
-
Se réveiller pour rien est le cas normal. Rien à faire, elle se rendort. C'est la moitié des réveils, et ce n'est pas une panne — c'est le comportement attendu d'un système conçu pour l'attente active plutôt que le blocage.
Quatre agents, quatre responsabilités
La gouvernance qui garde la cohérence quand des dizaines d'agents écrivent en parallèle repose sur une séparation stricte des rôles — en particulier entre celui qui code et celui qui vérifie. Quatre agents se partagent le pipeline, chacun avec un modèle et une règle non négociable :
|
Agent |
Rôle |
Sa règle |
|---|---|---|
|
loop-architect |
Spec gouvernée + Test Contract défini en amont, puis implémentation en une passe. |
Ne s'auto-certifie jamais ; en re-run, il affine le spec, ne le régénère pas. |
|
loop-qa |
Rejoue exactement le Test Contract, traite les notes d'implémentation comme un claim à vérifier. |
Ne transforme jamais un FAIL en PASS en affaiblissant un test. |
|
loop-shipper |
Push, ouvre la PR, watch CI + review, auto-remédie jusqu'à CAN MERGE. |
Ne merge jamais — le merge reste une décision humaine. |
|
e2e-tester |
Rebuild la CLI depuis les sources, l'utilise réellement en local, vérifie la finalité de bout en bout. |
Toujours rebuilder la CLI et pouvoir l'utiliser en local — jamais juger sur des tests unitaires seuls. |
Le détail qui compte ici n'est pas la liste des modèles, c'est la logique de séparation : celui qui écrit le Test Contract ne se certifie jamais lui-même, celui qui vérifie ne peut pas affaiblir un test pour le faire passer, et celui qui merge n'est jamais un agent. Chaque garde-fou correspond à un mode de dérive précis qu'une boucle sans surveillance humaine peut produire si on ne le bloque pas explicitement.
Le bilan chiffré : 73 requirements, 443 agents, 7,76 milliards de tokens
En quinze jours, la boucle a livré 73 requirements en orchestrant 443 agents. Au total, 7,76 milliards de tokens consommés — le chiffre brut, avant de parler de ce qu'il a vraiment coûté (la section suivante y revient en détail, et la différence entre les deux est le vrai enseignement économique de l'expérience).
Le coût suit ce qu'on ajoute au système : quatre paliers
Après le tout premier shot solo, chaque palier n'ajoute ou ne retire plus qu'un seul composant au système — et le coût par jour suit très précisément cette logique d'empilement.
- 16 juin — Ultracode seul. Le tout premier shot : /ultracode sort la brique initiale, sans aucune boucle. 49 M tokens/jour, 1 shot.
- 18 juin — + la boucle. /loop tourne pour la première fois. 234 M tokens/jour.
- 19–22 juin — + ultracode. Une couche posée par-dessus la boucle — en plus, pas à sa place. 811 M tokens/jour, soit +28 %.
- 23–30 juin — − ultracode. Retiré. La boucle seule tient le niveau, moins cher que la couche en plus. 634 M tokens/jour, soit −22 % par rapport à la configuration avec ultracode.
Ce qu'il faut en retenir : ajouter un outil supplémentaire au-dessus d'un système déjà autonome n'est pas neutre. /ultracode en complément de la boucle n'a rien apporté qui justifie son coût — la boucle seule fait aussi bien, pour près d'un quart moins cher.
Pourquoi l'API Claude n'a pas de mémoire (et pourquoi ça compte)
On vient de voir le volume grimper palier après palier, jusqu'à ×10 sur la boucle seule. Ce volume envoyé n'est pourtant pas ce qui est facturé : l'API Claude est sans état, rien n'est gardé entre deux appels, donc chaque appel renvoie toute la conversation depuis le début. Suivons un agent qui démarre pour voir ce qui, dans ce renvoi, est vraiment payé.
- Il démarre. On envoie tools → system → messages, dans cet ordre. Rien en cache : tout est payé plein tarif. Le marqueur est posé à la fin — Anthropic garde ce préfixe.
- Il vient de lire un fichier. tools et system ne bougent jamais. On renvoie tout le précédent — relu depuis le cache, environ 10 % du prix — plus le contenu du fichier, seul élément neuf.
- Il vient de lancer les tests. Le marqueur a avancé dans messages — tools et system, toujours identiques, restent en cache. Seule la sortie des tests est neuve.
... et ainsi de suite, des dizaines de fois par tick. Le volume envoyé explose, mais 97 % n'est que du contexte relu.
L'analogie retenue pendant la conférence est celle d'un signet dans un livre : à chaque appel, on rejoue tout ce qui précède le signet — en diagonale, quasi gratuit — puis on lit vraiment la suite. Un seul octet déplacé avant le signet, et tout ce qui suit redevient neuf, plein tarif.
Ce que ça a vraiment coûté : 97 % de cache-read, mais pas 97 % gratuit
Reste la question qui compte : combien ça a coûté avec le cache, et combien ça aurait coûté sans — deux totaux calculés sur le même volume de contexte.
Sur cette base, la facture réelle (compteurs pondérés par leur tarif, Opus 5) atteint environ 5 593 $. Le même volume de contexte, envoyé sans aucun cache — tout au tarif plein — aurait coûté environ 39 425 $. Soit un facteur ×7 moins cher, ou -86 % : c'est le cache, et non l'absence de travail, qui a tenu le budget.
Le détail des tarifs explique pourquoi l'écart est si marqué : une entrée plein tarif coûte 5 $/MTok, une écriture en cache 6,25 $/MTok, une lecture en cache seulement 0,50 $/MTok, et une sortie 25 $/MTok. Avec 97 % du volume envoyé qui n'est que du contexte relu, la quasi-totalité de la facture bascule sur le tarif le plus bas — d'où l'écart d'un facteur sept entre les deux totaux.
Ce qui a marché, ce qui a bloqué
Le bilan à quinze jours n'est pas unilatéralement positif. Côté réussites : la boucle autonome a réellement livré 73 requirements ; la gouvernance garde la cohérence quand des dizaines d'agents écrivent en parallèle ; les worktrees isolés permettent du parallélisme sans collision ; et un cache à 97 % maintient le coût réel sous contrôle.
Côté points de blocage : la gestion des tokens reste tendue, le fan-out d'agents brûle vite le budget ; la relecture des pull requests, seul poste réellement humain du pipeline, sature rapidement ; et trop d'idées lancées en parallèle disperse aussi bien la boucle que la personne qui la pilote.
Le vrai déclic : ce n'était pas une boucle, c'était un graphe
C'est à ce stade du récit qu'intervient le vrai retournement de la conférence, résumé en une phrase :
J'ai tapé /loop. Je n'ai pas fait de loop engineering. Je fais du graph engineering.
La définition qui tient, cette fois, vient de LangChain, dans un article de blog qui fêtait trois ans de graph engineering avec LangGraph : « Nodes do work… edges define what happens next. » Une boucle, c'est un graphe à un seul nœud. Le débat sémantique a d'ailleurs largement dépassé le cercle WeScale : un tweet de Peter Steinberger, vu 3,1 millions de fois, résume assez bien l'ambiance du moment — « Are we still talking loops or did we shift to graphs yet? »
La preuve par le diagramme : les chemins qu'une boucle ne peut pas avoir
Reprenons le parcours en cinq étapes présenté plus haut — dépôt du requirement, lancement des boucles, travail autonome, relecture, merge. Décrit ainsi, ça ressemble à une ligne qui tourne. Sauf qu'il manque des flèches essentielles : la CI peut renvoyer vers l'implémentation sans intervention humaine, et l'implémentation peut remonter un blocage qu'elle n'a pas su résoudre seule vers la personne qui pilote. Ce n'est pas une ligne qui tourne. C'est un graphe, avec deux chemins de retour bien distincts — l'un entièrement automatisé, l'autre qui remonte explicitement vers l'humain.
Cette distinction n'est pas un détail de vocabulaire. Elle change la façon dont on conçoit le système : une boucle qui échoue recommence depuis le début ; un graphe qui échoue reprend au nœud pertinent, avec le contexte de ce qui a déjà été tenté.
Deux boucles, un seul état, zéro collision
Nommer la forme ne sert à rien en soi. Ce qu'elle rend possible, en revanche, si : deux processus autonomes qui tournent en même temps, qui écrivent au même endroit, et qui ne se corrompent jamais l'un l'autre. Trois règles structurent cette cohabitation.
- Un état, un seul propriétaire. Celui qui code (build) ne touche jamais à la pull request ; celui qui livre (ship) ne retouche jamais le code.
- CI rouge, ce n'est pas « on recommence ». C'est un relais : ship rend la main à build, qui reprend à la spec — pas au début.
- Deux cadences, un seul fichier d'état. build toutes les 15 minutes, ship toutes les 3 minutes, et jamais deux écritures en même temps.
Je voulais faire du loop engineering. J'ai fini par écrire un graphe d'états avec des propriétaires — et c'est la seule raison pour laquelle je pouvais lancer deux boucles et aller me coucher.
Et aujourd'hui ? De l'atelier personnel à la chaîne de production
Le passage du prototype personnel à un usage d'équipe s'est fait sans rupture de logique : même cycle de vie, autre support. Plus rien ne tourne sur le poste de la personne qui a mené le projet — le requirement est devenu un ticket Linear, et un fil Slack par ticket raconte la suite : pris en charge, PR prête, PR mergée.
- Le ticket — déposé sur Linear. Plus d'inbox/ sur un disque local.
- Le triage — un agent juge : quel dépôt, implémentable ou pas. En cas de doute, il s'arrête plutôt que de deviner.
- Le dispatch — la CI lit les tickets labellisés toutes les quinze minutes.
- L'implémentation — Claude Code tourne sur la CI. Il ouvre la pull request.
- La relecture — humaine. Toujours le seul geste terminal du pipeline.
L'architecture conceptuelle — état partagé, propriétaires uniques, deux cadences, relecture humaine comme seul geste terminal — n'a pas changé en passant du poste personnel à la CI d'équipe. Seul le support a changé : un système de fichiers local a cédé la place à Linear et Slack, /loop en local a cédé la place à un déclenchement CI sur Bedrock.
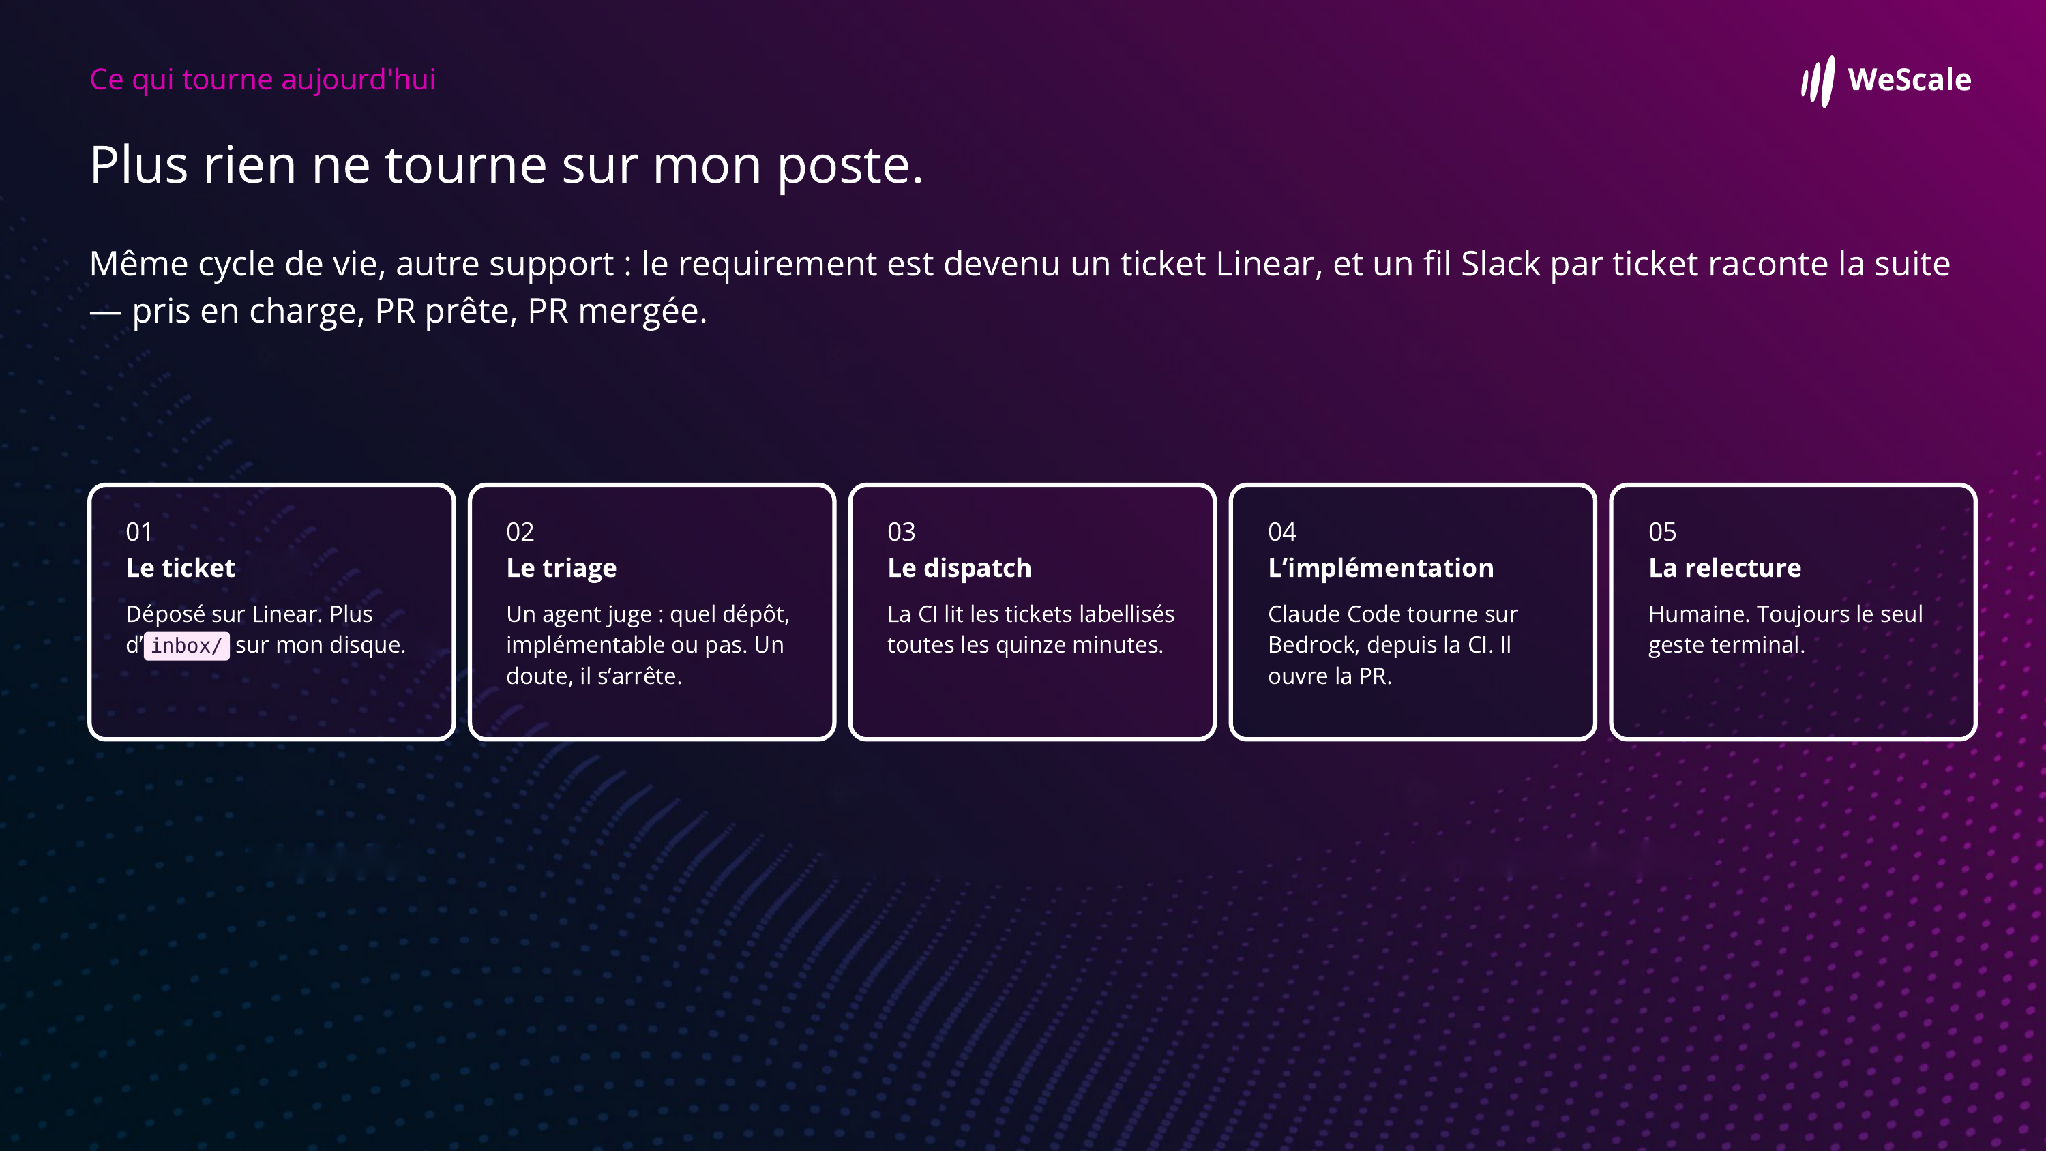
Ce qui tourne aujourd'hui : ticket Linear, triage, dispatch CI, implémentation sur Bedrock, relecture humaine.
Conclusion : le code, il l'a surtout relu
Le résumé le plus honnête de ces quinze jours tient en une phrase : le code, la personne qui a mené le projet l'a surtout relu. Les agents l'ont écrit. Et la boucle, en vrai, c'était un graphe.
Ce qui a permis à ce système de tourner sans supervision constante n'est ni la puissance des modèles ni le nombre d'agents mobilisés, mais une discipline d'ingénierie assez classique appliquée à un nouveau contexte : séparer clairement qui écrit de qui vérifie, donner à chaque état un seul propriétaire, concevoir explicitement les chemins de retour plutôt que de les découvrir en production, et ne jamais confier à un agent la décision finale de merge.
Comme indiqué dans notre charte IA, cet article a été rédigé avec l'assistance d'une IA.