 Morgan Blanloeil
Au 20e tour d'une conversation, un agent envoie 59 500 tokens au modèle pour recevoir une réponse de 500. Il paie les 59 500. Au tour suivant, il les repaiera, plus le nouveau message, parce que le modèle ne garde rien d'un appel à l'autre.
Sur 20 tours, avec Claude Sonnet 5.5 et sans cache, cette conversation coûte 1,53 $. L'input en représente 93 %, alors qu'un token d'output coûte 5 fois plus cher qu'un token d'input.
93 % de la facture. Pour relire.
Le context engineering consiste à choisir ce qui entre dans la fenêtre du modèle à chaque appel. Dans cet épisode de la série, je regarde ce choix par la facture : ce qu'on paie, pourquoi, et quels réglages la font baisser. Sur le même agent, le prompt caching seul ramène la note à 0,31 $.
Pourquoi le modèle relit-il tout à chaque tour ?
L'API d'un LLM est sans état. À chaque appel, le client renvoie tout le contexte : instructions, définitions d'outils, documents, historique. Le modèle le lit, répond, puis oublie. Même quand le fournisseur stocke la conversation pour vous, tous les tokens de la chaîne sont refacturés.
Un appel se déroule en deux phases, toujours dans cet ordre :
- Prefill : le modèle lit tout l'input d'un coup, en parallèle, et en garde une mémoire de travail, le KV cache. Cette phase fixe le délai avant le premier mot.
- Decode : le modèle écrit la réponse un token après l'autre, sans pouvoir paralléliser. C'est pourquoi un token de sortie coûte plusieurs fois le prix d'un token d'entrée.
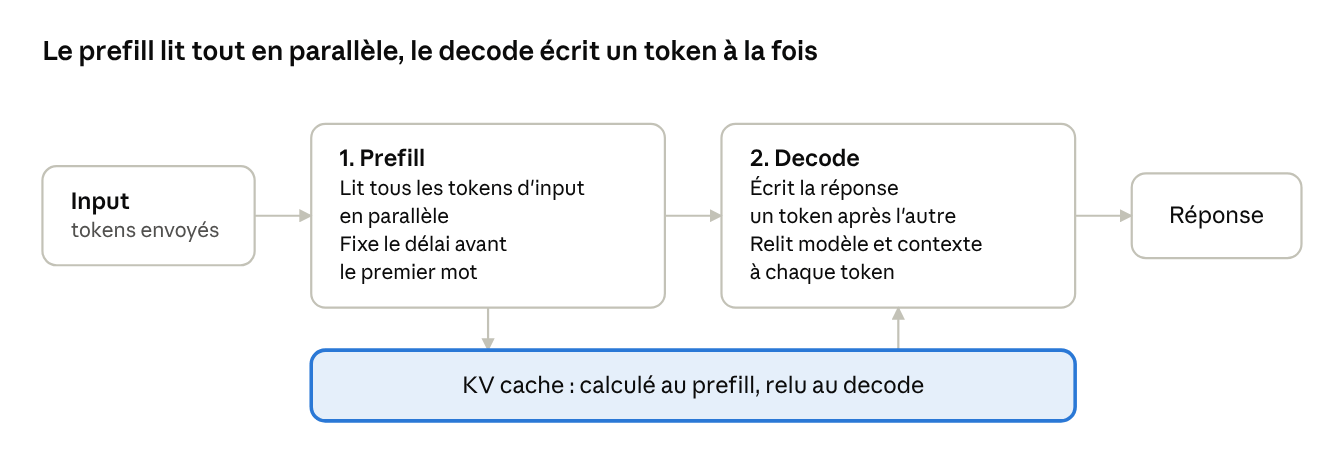
Le KV cache peut être sauvegardé d'un appel à l'autre : c'est le prompt caching, détaillé plus bas. Sans lui, il disparaît à la fin de l'appel et, au tour suivant, tout l'input repasse en prefill et est refacturé.
Que paie-t-on, au juste ?
La facture d'un appel additionne des compteurs de tokens, chacun multiplié par son prix au million (MTok). Les principaux fournisseurs partagent cette base.
Trois postes se partagent la note :
- Input : tout ce qui est envoyé, relu et refacturé à chaque tour. Il a deux tarifs : le plein prix pour la partie hors cache, une fraction de ce prix pour la partie lue en cache (voir plus bas).
- Raisonnement : avant de répondre, un modèle de raisonnement écrit un brouillon où il décompose le problème, teste des pistes et se corrige. Ces tokens de réflexion sont facturés comme de l'output même quand le fournisseur ne les renvoie pas. Un modèle qui réfléchit 5 000 tokens pour répondre en 200 facture 5 200 tokens de sortie.
- Output : le texte visible et les appels d'outils générés, plus chers au token.
Les trois apparaissent dans le décompte usage renvoyé par l'API. C'est là qu'il faut regarder avant d'optimiser quoi que ce soit.
L'agent à 20 tours
Hypothèses : Claude Sonnet 5.5 à 2 $/MTok en input et 10 $/MTok en output (tarifs Anthropic). Un prompt système et des outils de 10 000 tokens. À chaque tour, 2 000 tokens de message et de résultats d'outils, et 500 tokens de réponse. Volontairement sans cache, pour mesurer le coût brut : on l'active plus bas, dans la partie sur le cache.
Résultat sur 20 tours : 715 000 tokens d'input pour 1,43 $, contre 10 000 tokens d'output pour 0,10 $. Total : 1,53 $.
Chaque tour renvoie tout ce qui précède, donc chaque tour coûte plus cher que le précédent. Passer de 10 à 20 tours multiplie l'input par trois : 232 500 tokens, puis 715 000. Le coût d'un agent se joue sur ce qu'il garde dans son contexte, pas sur la longueur de ses réponses.
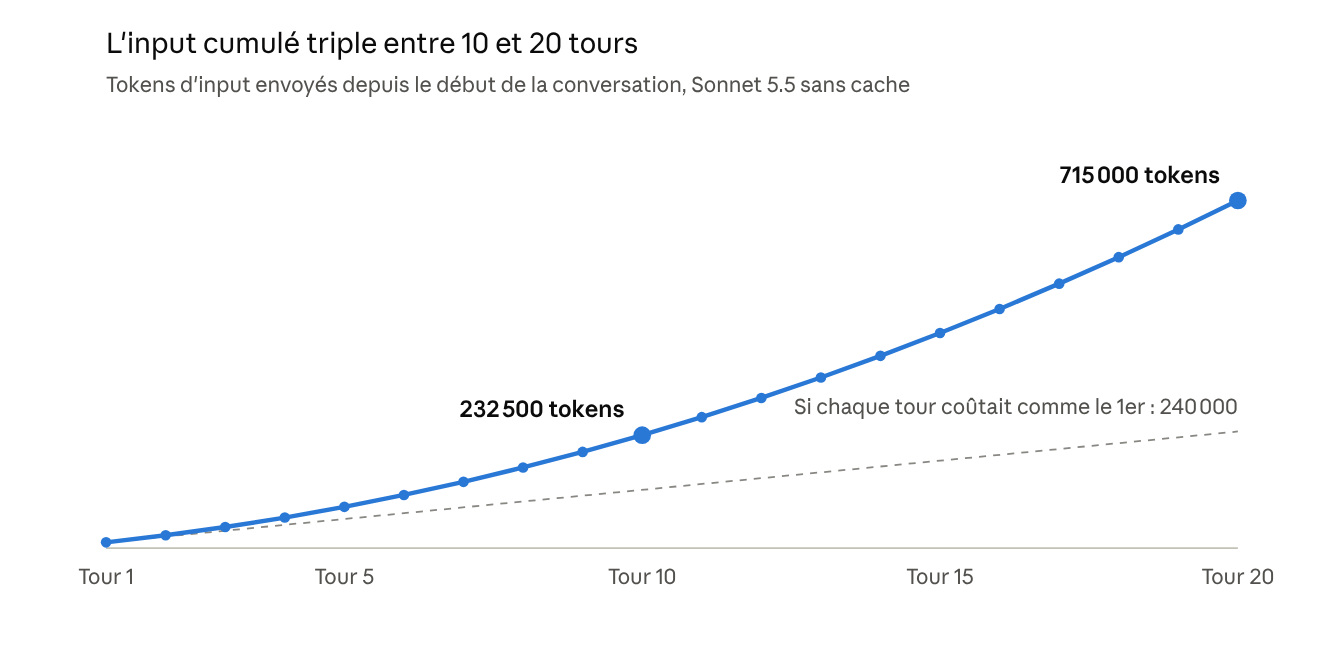
Calcul à partir des hypothèses ci-dessus : 10 000 tokens de prompt et d'outils, 2 500 tokens ajoutés par tour
Mais où partent tous ces tokens ?
La plupart des tokens facturés ne viennent pas de la question de l'utilisateur. Ils viennent de ce que l'agent traîne avec lui d'un tour à l'autre.
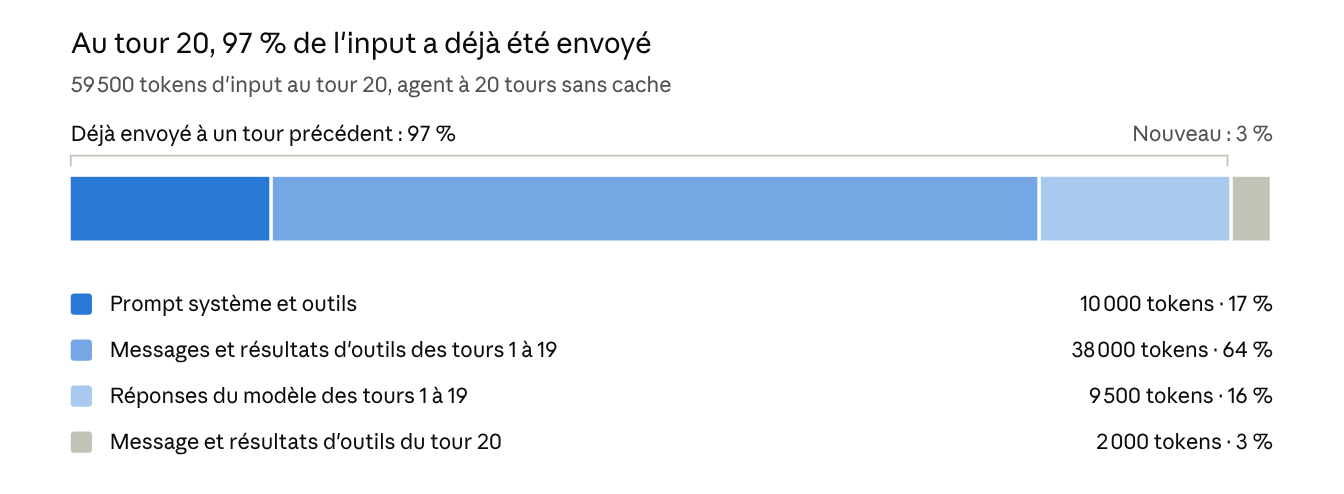
Sur les 59 500 tokens envoyés au tour 20, seuls 2 000 sont nouveaux. Le reste a déjà été envoyé, et payé, au moins une fois.
Les définitions d'outils. Un outil est une fonction que l'application met à disposition du modèle : chercher sur le web, lire un fichier, créer un ticket. Le modèle demande à l'appeler, l'application l'exécute et lui renvoie le résultat. Pour savoir quels outils existent, le modèle doit recevoir à chaque appel leurs noms, descriptions et schémas JSON. Un agent branché à 20 outils décrits en 150 à 300 tokens chacun envoie 3 000 à 6 000 tokens avant même la question, soit 60 000 à 120 000 tokens sur 20 tours.
Remède : ne charger que les outils utiles à la tâche, et les outils rares à la demande (tool search).
Les résultats d'outils. Ce que l'agent lit reste dans l'historique et se repaie à chaque tour. Un PDF de 500 kB pèse environ 125 000 tokens (source). Lu au premier tour d'une conversation de 10 tours, il est renvoyé 10 fois : 2,50 $ pour un seul document. Lu une fois, payé dix.
Remède : borner les résultats à la source (pagination, extraits, max_content_tokens sur le web fetch d'Anthropic), ou déléguer la lecture à un sous-agent, qui lit 200 000 tokens de code et ne renvoie que 2 000 tokens de conclusion.
Les réponses du modèle. La sortie du tour n devient de l'input au tour n+1. Une réponse de 2 000 tokens au tour 1 est facturée une fois en output, puis renvoyée dans les 19 tours suivants : 38 000 tokens d'input de plus. Une réponse verbeuse se paie donc deux fois.
Les sessions jamais coupées. Comme chaque tour repaie tout l'historique, le coût d'input croît à peu près avec le carré du nombre de tours. Une conversation de 20 tours qui aurait pu repartir de zéro au tour 10 coûte 1,5 fois plus cher en input que deux sessions de 10 tours : 715 000 tokens contre 465 000.
Remède : au bout de quelques tours, remplacer les vieux résultats d'outils par « effacé » (context editing), ou repartir d'une session neuve avec un court résumé (compaction).
Le cache, ou comment payer 5 % du prix
L'input est le plus gros levier. Le prompt caching garde le KV cache du début du prompt d'un appel à l'autre : si ce début est identique, le fournisseur saute son prefill et le facture 5 % du prix d'input sur Sonnet 5.5, et 10 % sur la plupart des autres modèles chez Anthropic, OpenAI ou Mistral. Sur l'agent à 20 tours, la facture passe de 1,53 $ à 0,31 $. Sans changer un mot du prompt.
Le premier tour coûte un peu plus cher, car l'écriture en cache est facturée 1,25 fois le prix d'input. Ensuite, chaque tour lit le reste en cache à 0,05× et paie l'écriture de ses 2 500 nouveaux tokens.
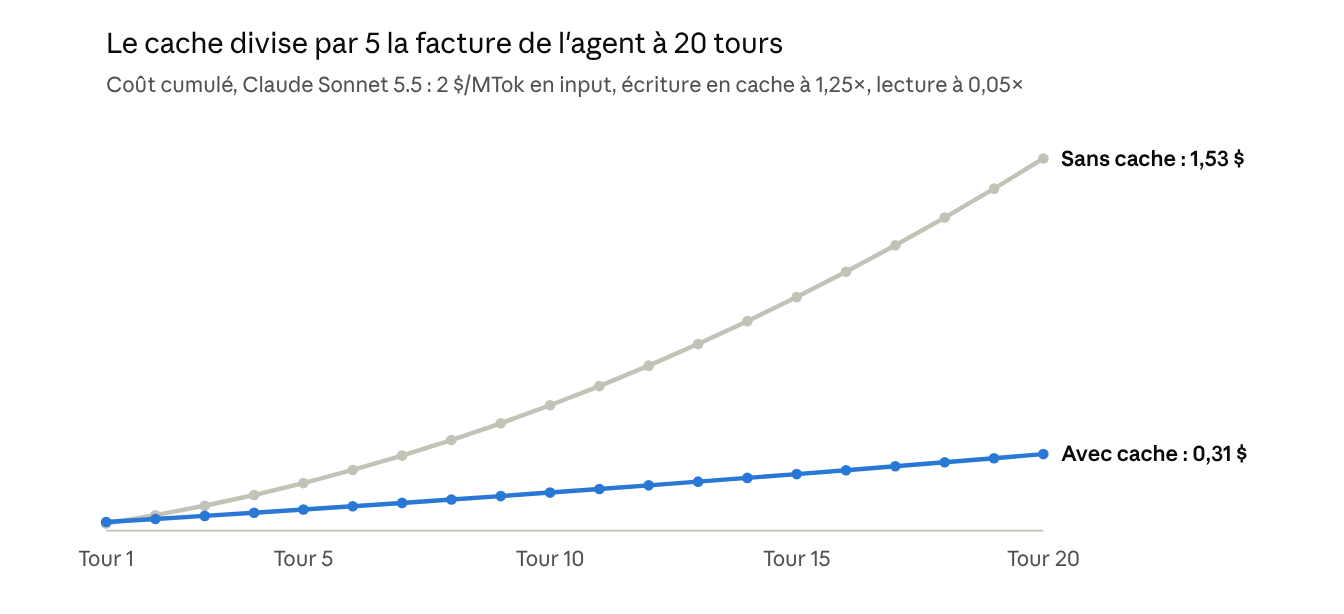
Les deux courbes partent du même point, puis l'écart se creuse à chaque tour : avec le cache, l'historique est relu à 5 % du prix au lieu de 100 %.
Comment le cache décide
Un seul non suffit : tout l'input repasse en prefill, au plein tarif.
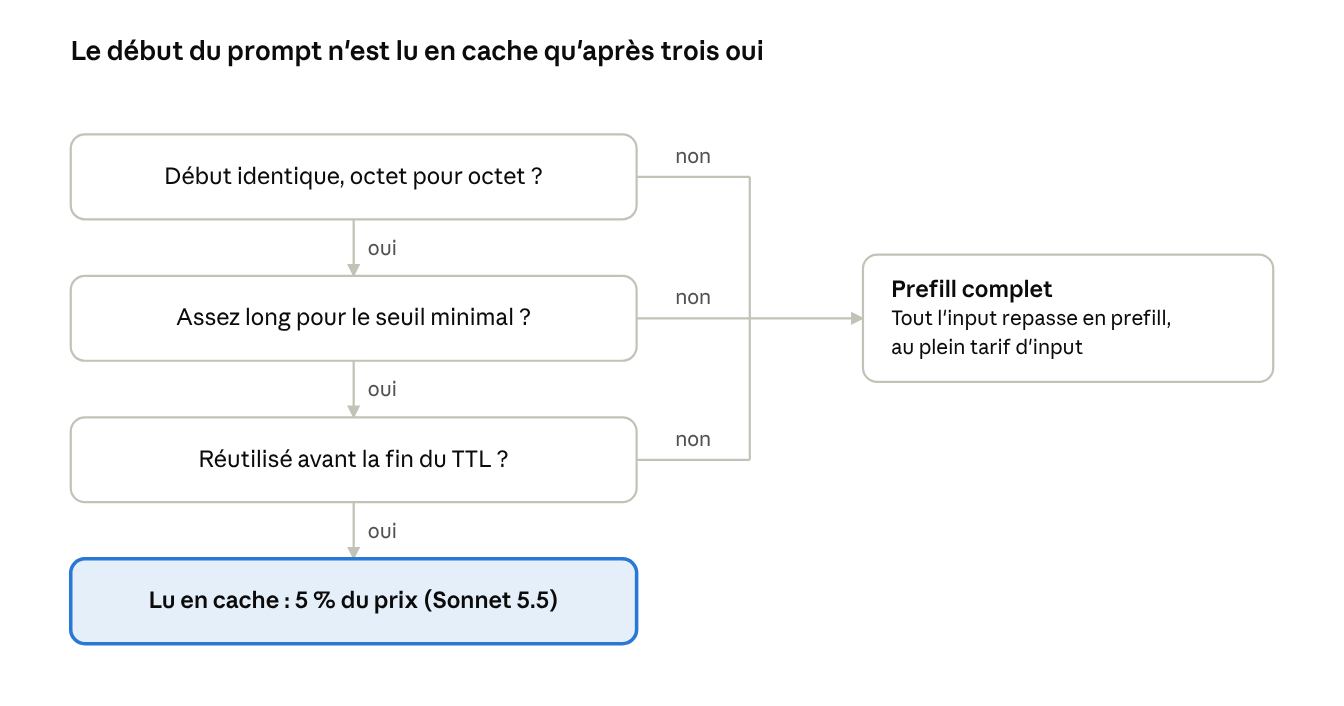
Correspondance de préfixe. Le cache ne porte que sur le début du prompt, octet pour octet. Un seul caractère modifié invalide tout ce qui suit.
Taille minimale. En dessous d'un seuil, rien n'est mis en cache, et aucune erreur ne le signale : 512 tokens sur Claude Sonnet 5.5 et Opus 5.5.
Durée de vie limitée. Le cache expire après une période sans usage, de quelques minutes à quelques jours selon les fournisseurs.
Écrire un prompt qui reste en cache
Une date en tête du prompt système suffit à casser le cache de tout ce qui suit.
Cinq règles gardent ce début de prompt identique d'un appel à l'autre :
- Du plus stable au plus volatil :
- les outils ;
- les instructions système ;
- les documents de référence ;
- l'historique ;
- la question du tour.
- Rien de dynamique en tête : pas de date, d'horodatage, d'identifiant de requête ni de nom d'utilisateur dans le prompt système. Si je ne devais retenir qu'un piège, ce serait celui-là : c'est la première cause de cache cassé, et personne ne s'en rend compte.
- Une sérialisation déterministe : JSON aux clés triées, outils toujours dans le même ordre.
- Un historique en ajout seul : une instruction ajoutée en cours de conversation va à la fin, pas dans le prompt système.
- Un modèle par conversation : le cache est propre à chaque modèle, et changer de modèle en cours de route le perd.
Pour vérifier que le cache est bien lu, il suffit de lire cache_read_input_tokens (Anthropic), cached_tokens (OpenAI) ou prompt_cache_hit_tokens (DeepSeek). Un compteur à zéro sur des requêtes répétées signale un préfixe qui change.
Attention : résumer ou réécrire l'historique invalide le cache à partir du passage modifié ; seuls les outils et les instructions système, placés avant, restent en cache. Compaction et cache se règlent ensemble.
Et l'output dans tout ça ?
L'output pèse peu dans la facture de l'agent (0,10 $ sur 1,53 $), mais chaque token y coûte cinq fois plus cher. Le raisonnement, lui, peut multiplier ce poste sans rien montrer à l'écran.
| Poste | Ce qu'il borne | Réglage |
|---|---|---|
| Output | La longueur de la réponse visible | max_tokens, format imposé (JSON structuré, réponse courte) |
| Raisonnement | Les tokens de réflexion facturés en output | Niveau d'effort (low à max), ou budget de tâche sur les boucles agentiques |
Les deux réglages n'agissent pas pareil. max_tokens est une coupure que le modèle ne voit pas venir : une fois la limite atteinte, la réponse s'arrête en pleine phrase. Le niveau d'effort change le comportement du modèle : moins de réflexion, moins d'appels d'outils, des réponses plus sobres. À mon sens, c'est lui le vrai levier pour réduire le coût de sortie sans casser les réponses ; max_tokens n'est qu'un garde-fou.
Par où commencer ?
Mon conseil : ne retenez pas les prix, ils changent tous les trimestres. Retenez où regarder. Sur une conversation réelle de votre agent :
- Relevez les compteurs
usagede chaque tour : input, écriture et lecture en cache, output, raisonnement. - Repérez le poste qui pèse le plus. En multi-tours, c'est presque toujours l'input.
- Si l'input domine, vérifiez que le cache est lu, puis cherchez ce qui peut sortir du contexte : outils inutiles, résultats déjà exploités, vieux tours.
- Si le raisonnement domine, baissez l'effort sur les tâches simples.
Un contexte bien choisi rend l'agent moins cher, mais aussi plus précis : le modèle a moins de bruit à relire.
Les prix cités ont été vérifiés le 20 octobre 2026 ; les ordres de grandeur tiendront plus longtemps que les chiffres.
Alors avant d'ouvrir votre carte bleue, ouvrez votre usage.